1 Settings
更新: 2026/8/21 字数: 0 字 时长: 0 分钟
1.1 Pre Translate
上传在线文件转换时设置的参数,每次上传在线文件后,系统都会根据设置内容进行双语文件转换,预翻译、MT操作等
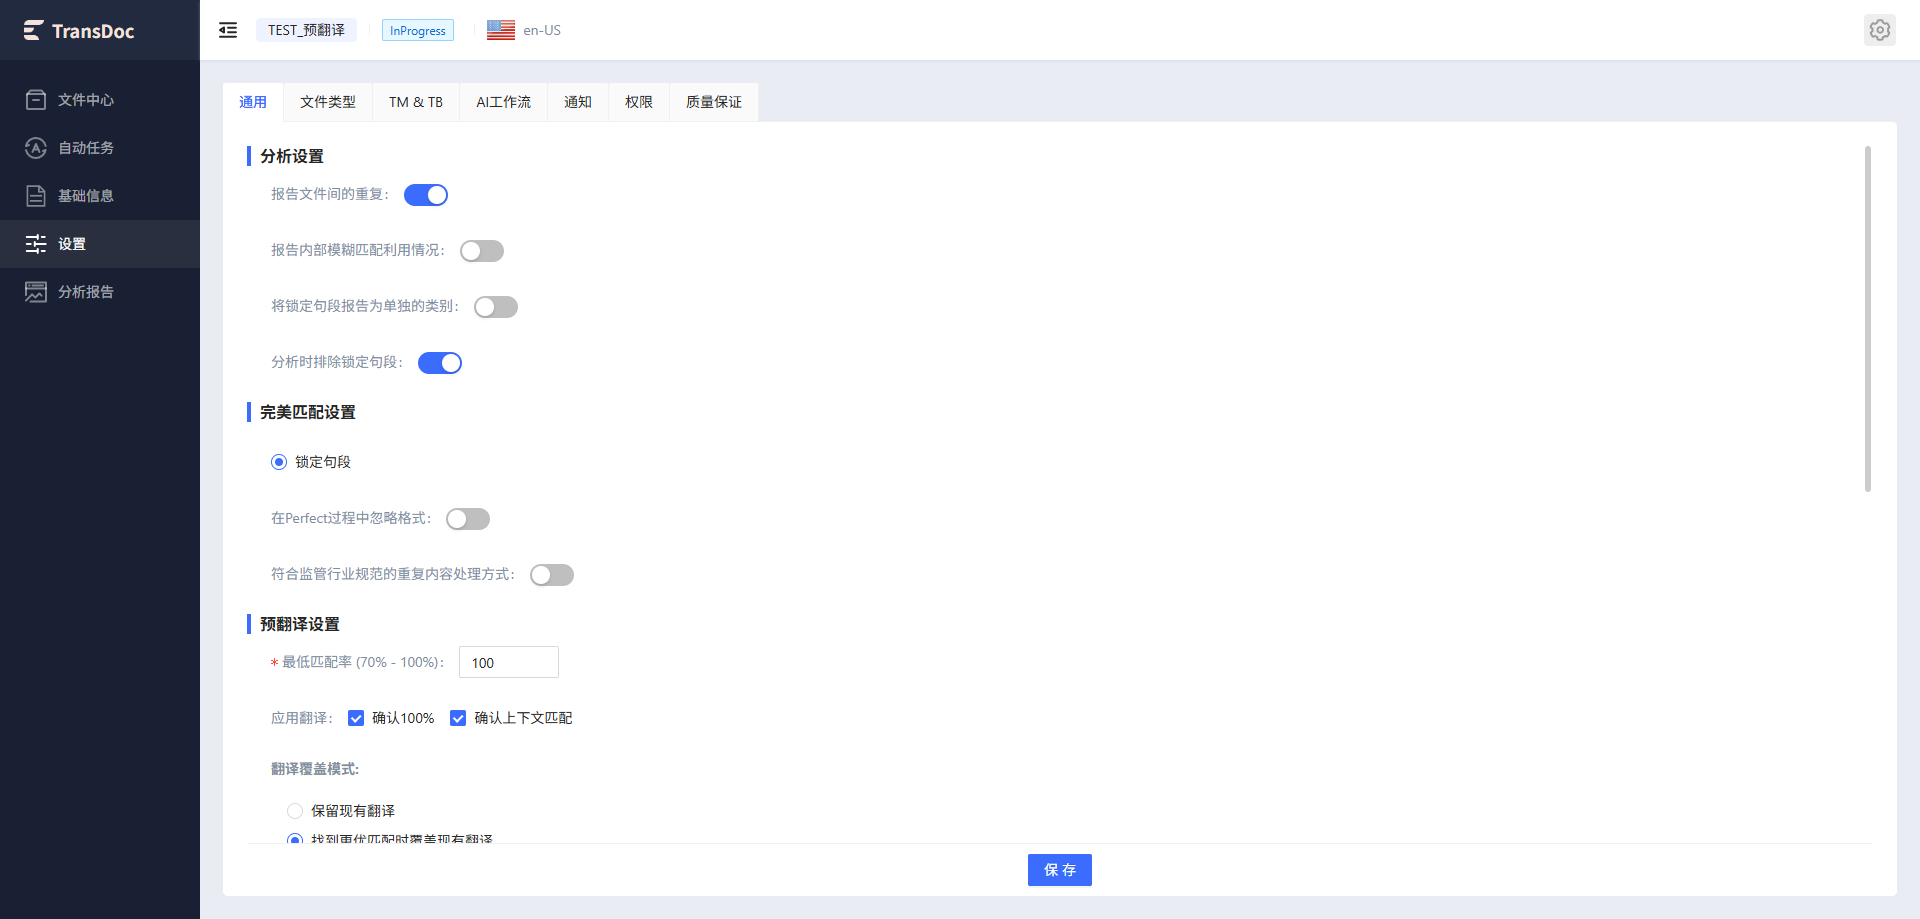
1.1.1 分析设置
- 报告文件之间的重复:允许跨文件Repetitions
- 报告内部模糊匹配清空:允许文件内部高模糊匹配
- 将锁定句段报告为单独的类别:解析时排除锁定句段
- 分析时排除锁定句段:分析中排除锁定句段
1.1.2 完美匹配设置
- 锁定句段:默认锁定,不可更改设定
- 在Perfect过程中忽略格式:在进行 Perfect Match(PM)匹配计算或应用 Perfect Match 时,不考虑原文和译文中的格式差异,只比较文本内容是否一致。
- 符合监督行业规范的重复内容处理方式:系统在处理重复句段(duplicate content / repeated segments)时,需要满足监管行业(如生命科学、医疗器械、制药)的合规要求,包括保证重复内容的一致性、可追溯性、审核记录和风险控制。
1.1.3 预翻译设置
最低匹配率:70-100%
应用翻译:
- 确认100%:将100%匹配句段状态变更为已确认
- 确认上下文匹配:将上下文匹配句段状态变更为已确认
翻译覆盖模式:
- 保留现有翻译
- 找到更优匹配时覆盖现有翻译:如果有更好的翻译则覆盖
- 始终覆盖现有翻译:始终用 TM 中的翻译替换现有翻译。
1.1.4 句段锁定设置
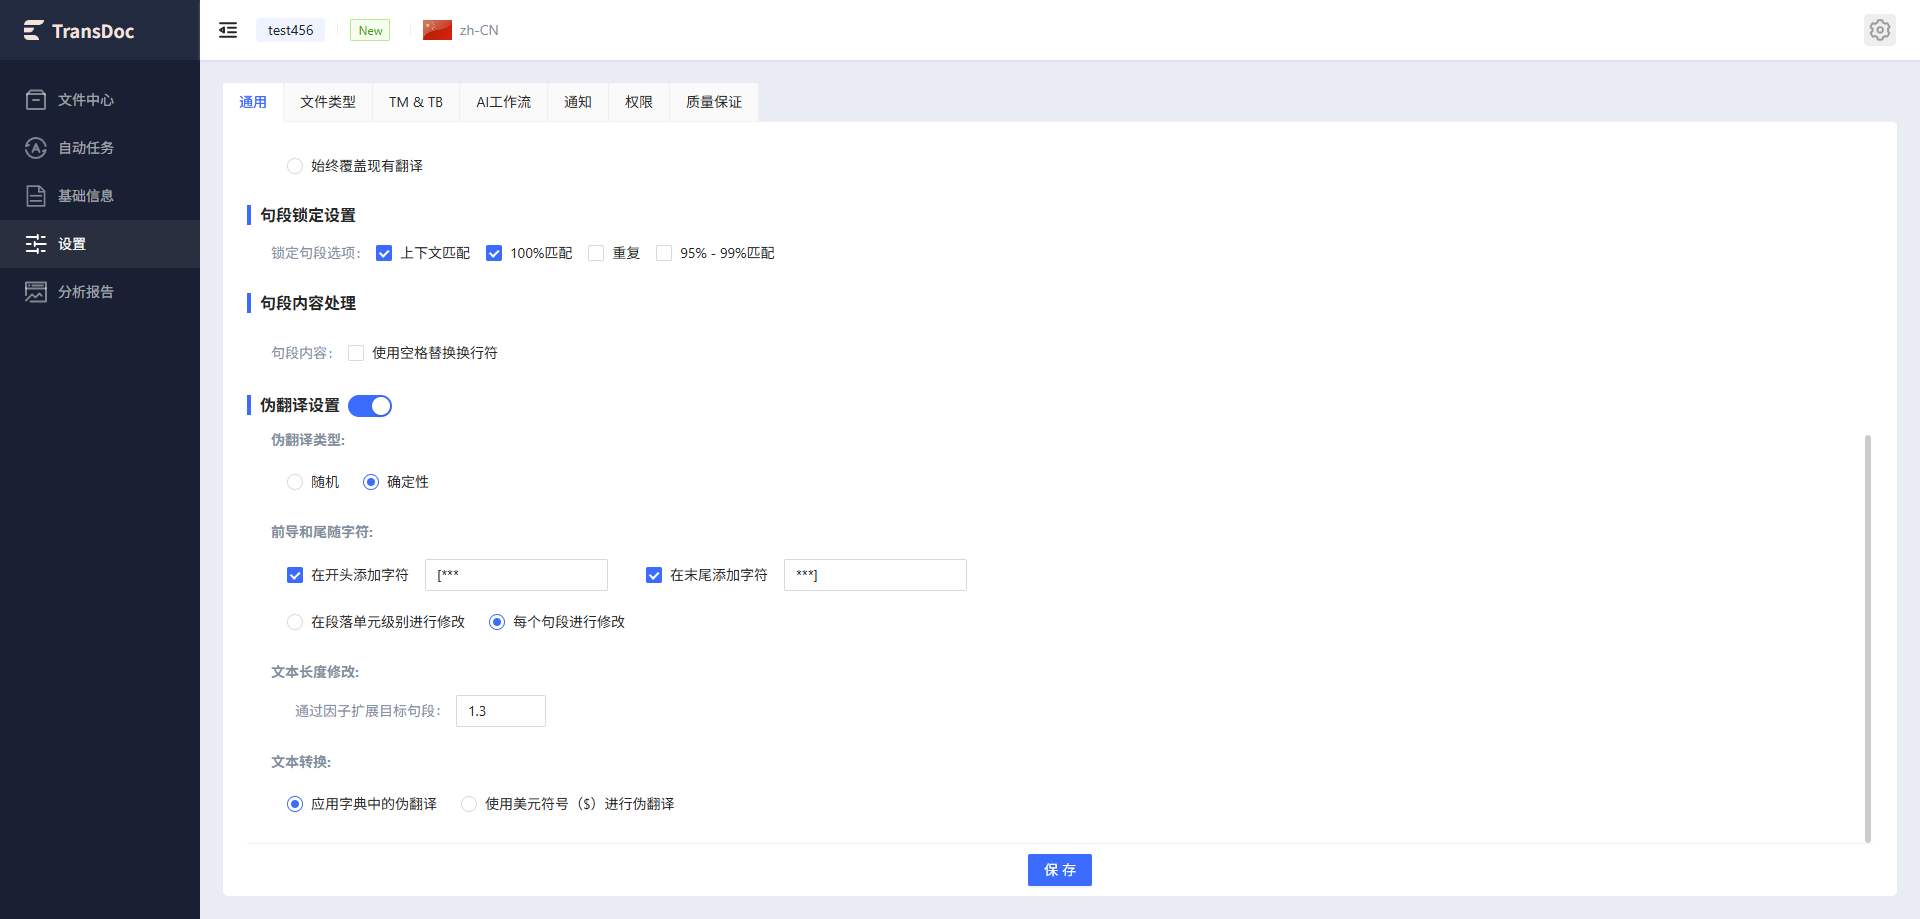
锁定句段选项:
- 上下文匹配:勾选后将锁定该区间句段
- 100%匹配:勾选后将锁定该区间句段
- 重复:勾选后将锁定该区间句段
- 95%-99%匹配:勾选后将锁定该区间句段
1.1.5 句段内容处理
- 使用空格替换换行符:会将句段原文中的换行符替换为空格
1.1.6 伪翻译设置
- 伪翻译类型:可选择随机或确定性;
- 前导和尾随字符:可设置在开头或结尾添加的字符;可选段落级别或句段级别进行修改;
- 文本长度修改:支持调整文本长度,输入数字即可,例如1.3代表增加30%长度
- 文本转换:支持使用应用字典或者使用美元符号进行伪翻译
1.2 FileType
文件解析器设置,上传的文件需要通过文件解析器来配置一些文件内容提取规则,同时部分文件格式目前支持可视化配置。
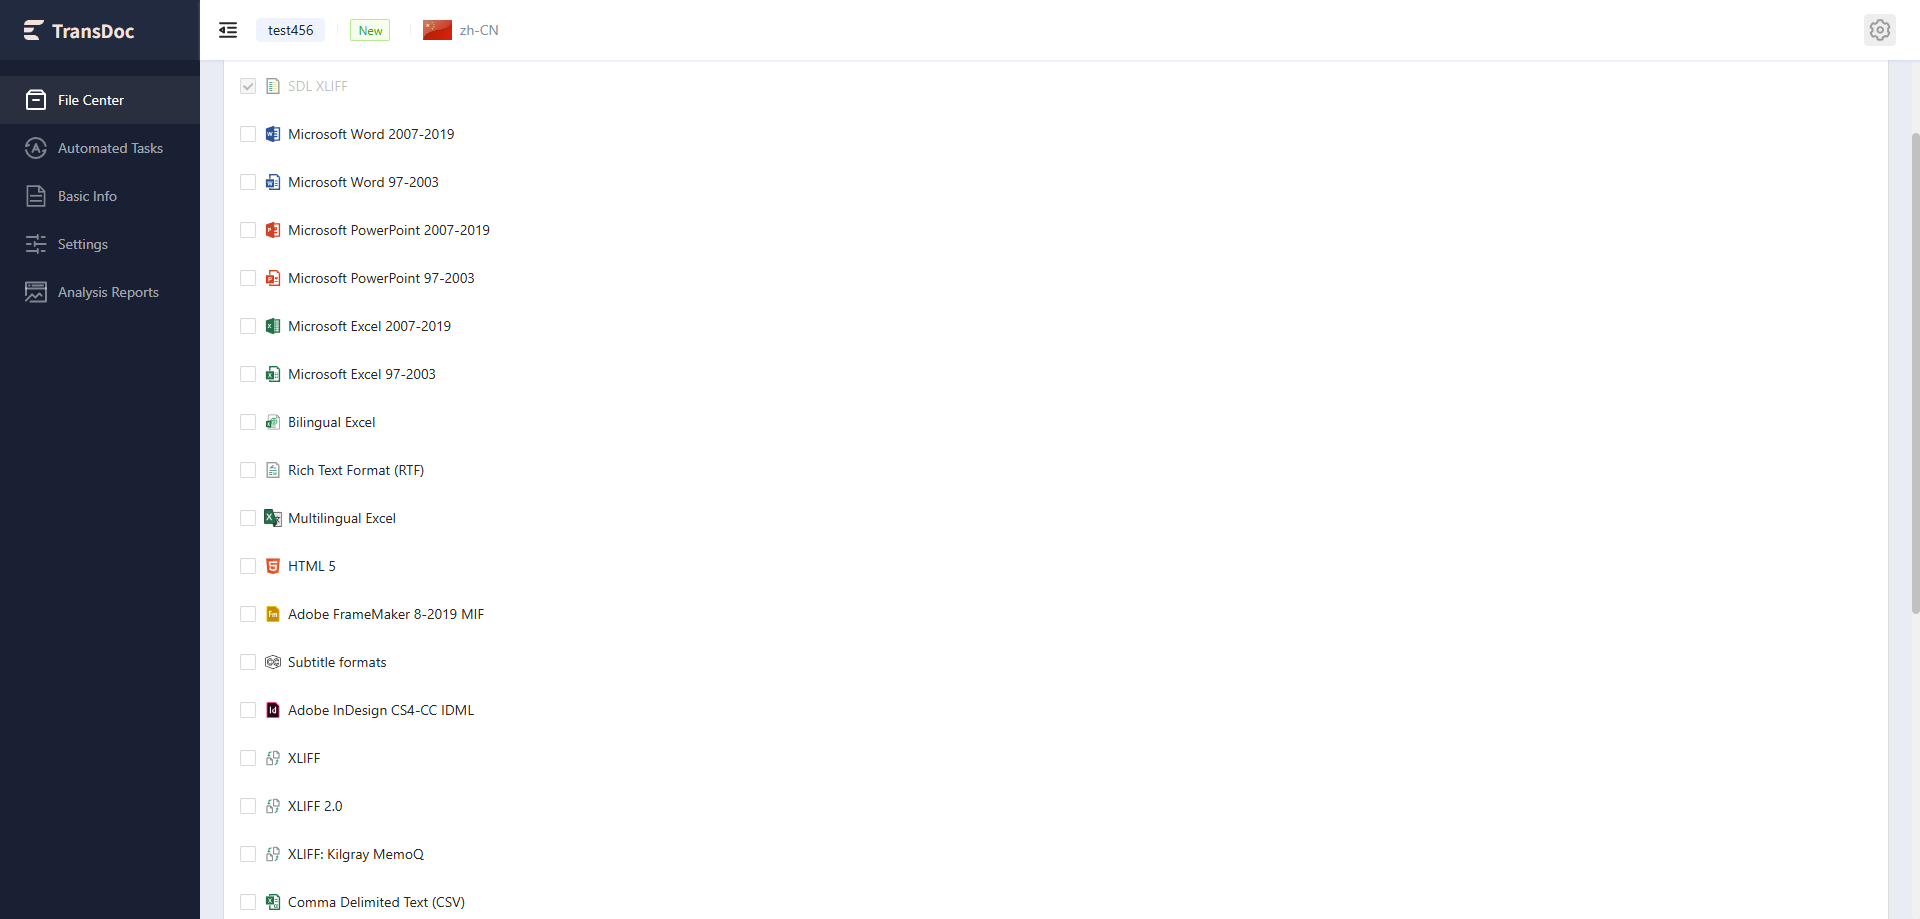
系统目前支持的文件原始格式
SDL XLIFF Microsoft Word 2007-2019 Microsoft Word 97-2003 Microsoft PowerPoint 2007-2019 Microsoft PowerPoint 97-2003 Microsoft Excel 2007-2019 Microsoft Excel 97-2003 Bilingual Excel Rich Text Format (RTF) Multilingual Excel HTML 5 Adobe FrameMaker 8-2019 MIF Subtitle formats Adobe InDesign CS4-CC IDML XLIFF XLIFF 2.0 Comma Delimited Text (CSV) Text XLIFF: Kilgray MemoQ Portable Object Markdown JSON XML 2: Any XML PDF Adobe FrameMaker 8-2020 MIF V2 XML 2: OASIS DITA 1.3 Compliant Microsoft Visio
1.3 TM&TB
通过本页可以调整项目的TM和TB设置
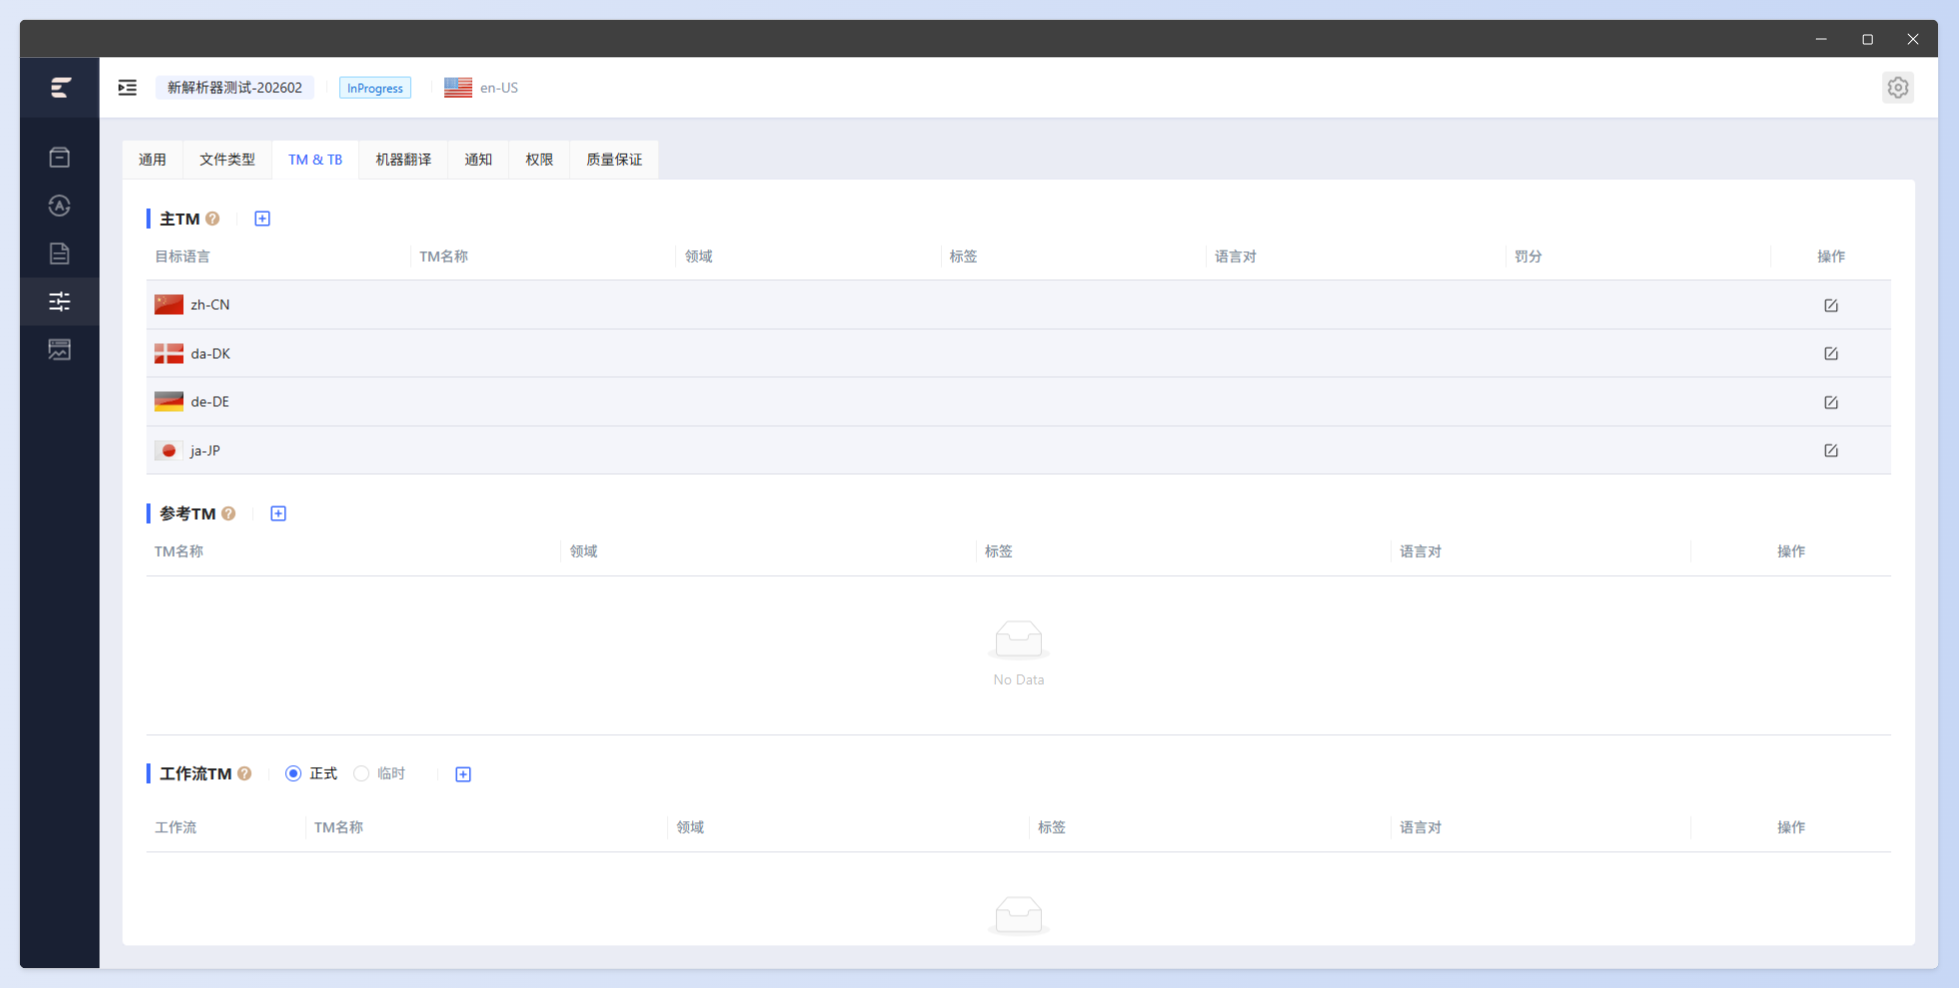
界面如下:
1.3.1 Master TM
Master TM即主TM,用于文件转换时候的分析计算,以及自动翻译等,在在线翻译过程中Master TM会作为只读TM在在线页面中提供查询,所以Master TM是必须设置的TM,如图所示点击+按钮,可以进行新建或选择已有TM进行关联。
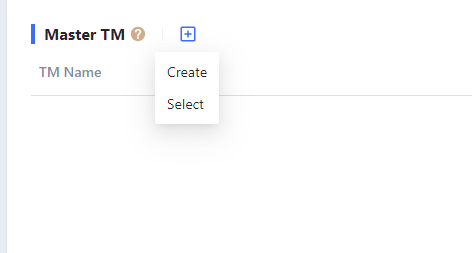
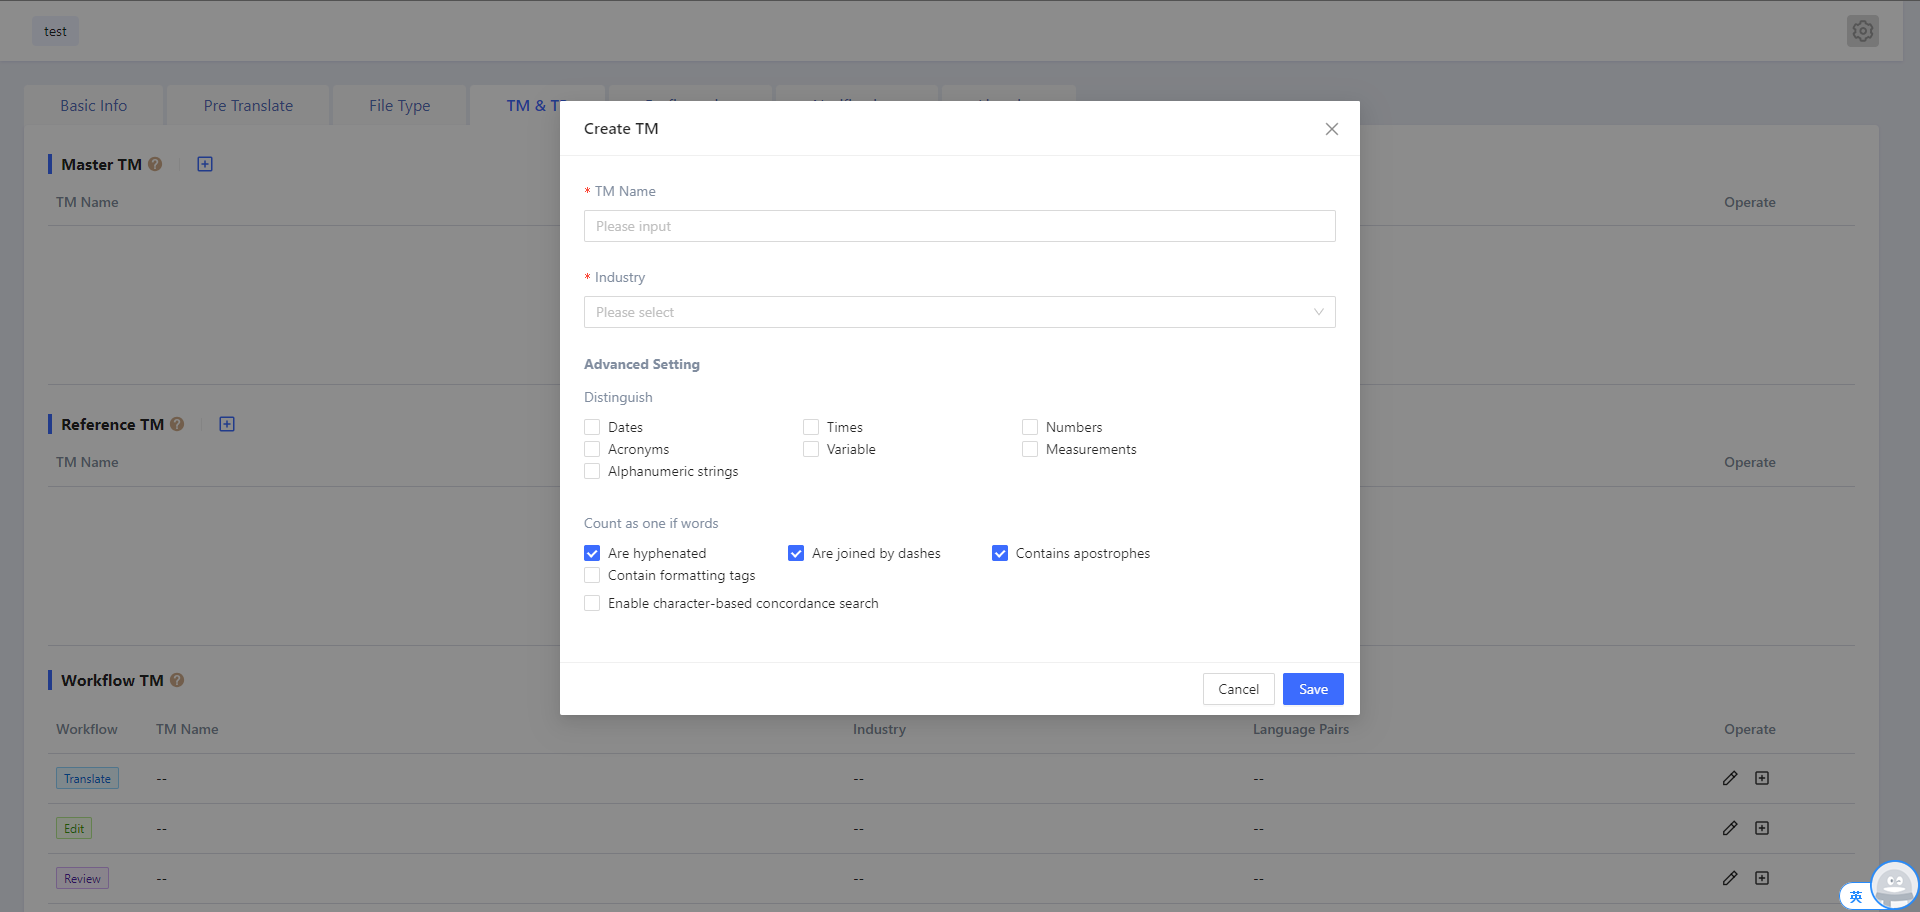
点击“Create”选项后弹出新建TM,需要输入TM名称、领域以及TM设置项等信息,输入完成后点击“Save”,就完成了新建。新建TM时默认语种是按照项目语种进行创建
点击选择TM按钮,可在弹窗中选择已经创建好的TM。默认筛选自己创建的,也可以查看全部TM。
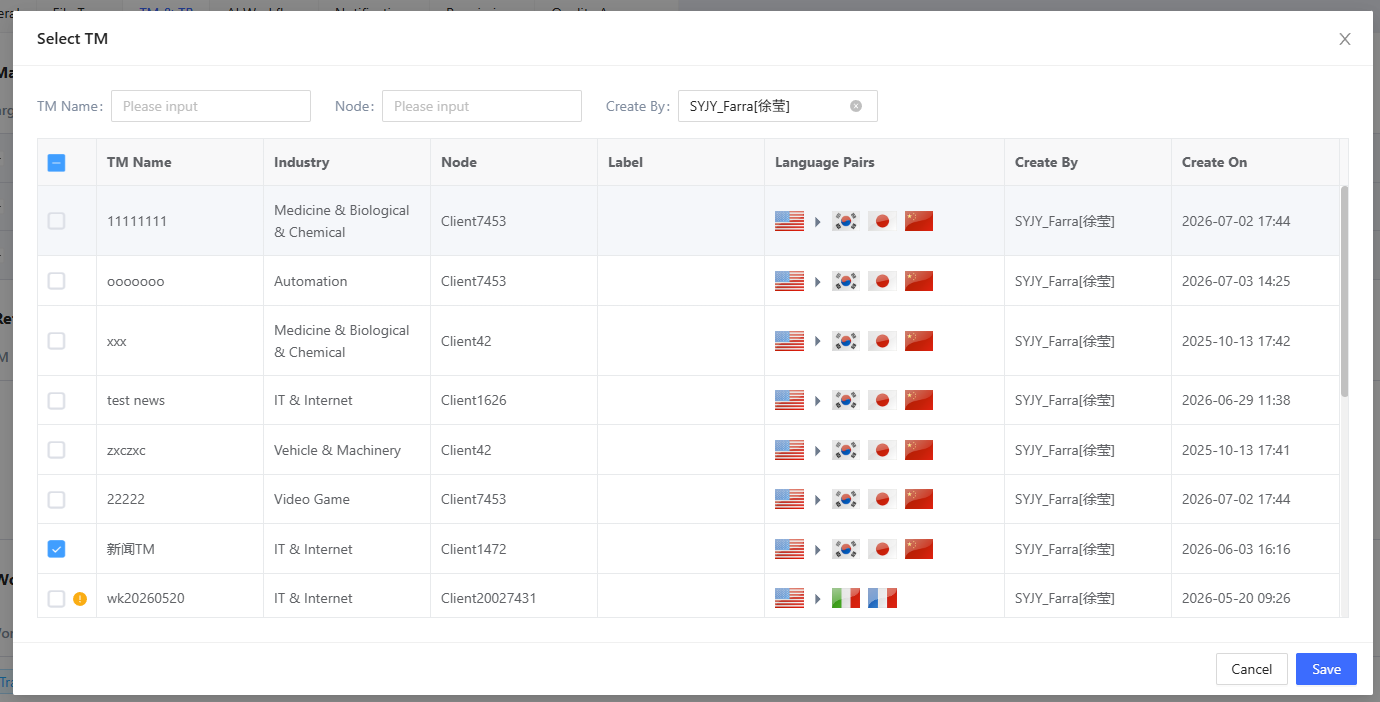
目前支持选择与项目源语言相同的TM,如果选择了目标语言不一致的TM,可在确认TM后自动添加。
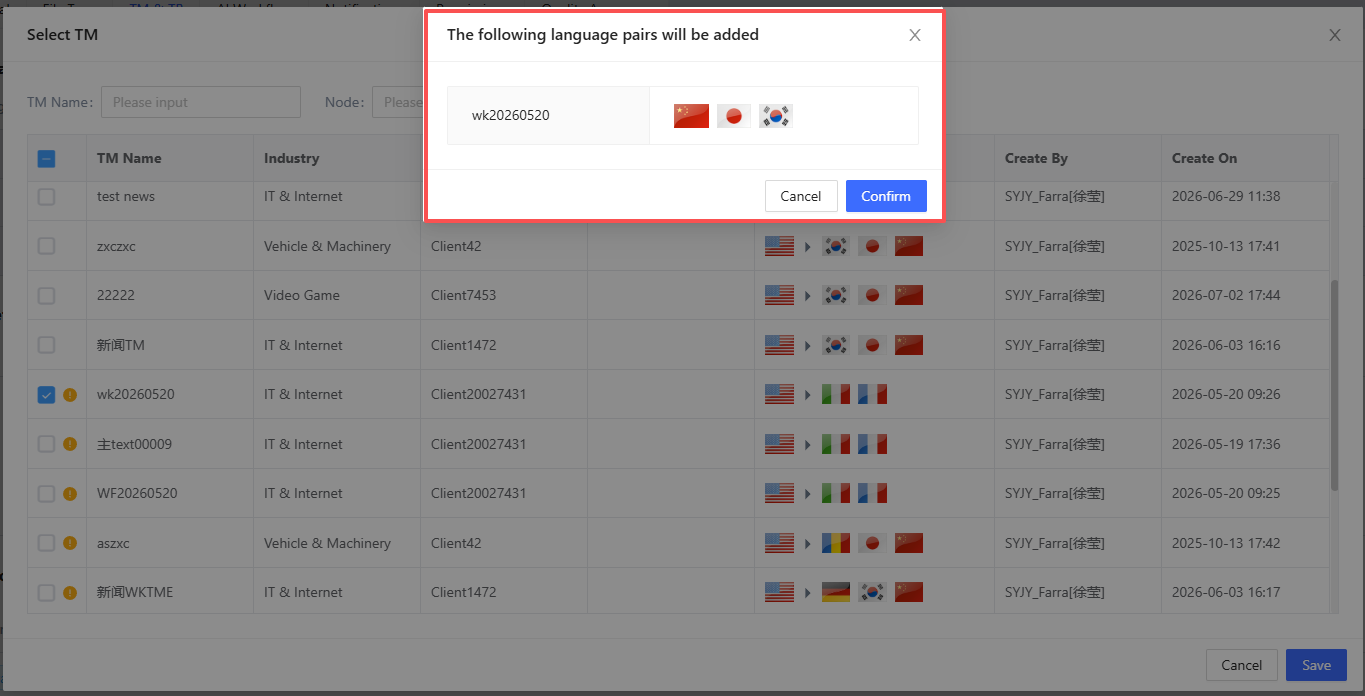
注意:同属一个组织的不同客户间的语言资产是可以共享的,列表页有所属客户字段显示
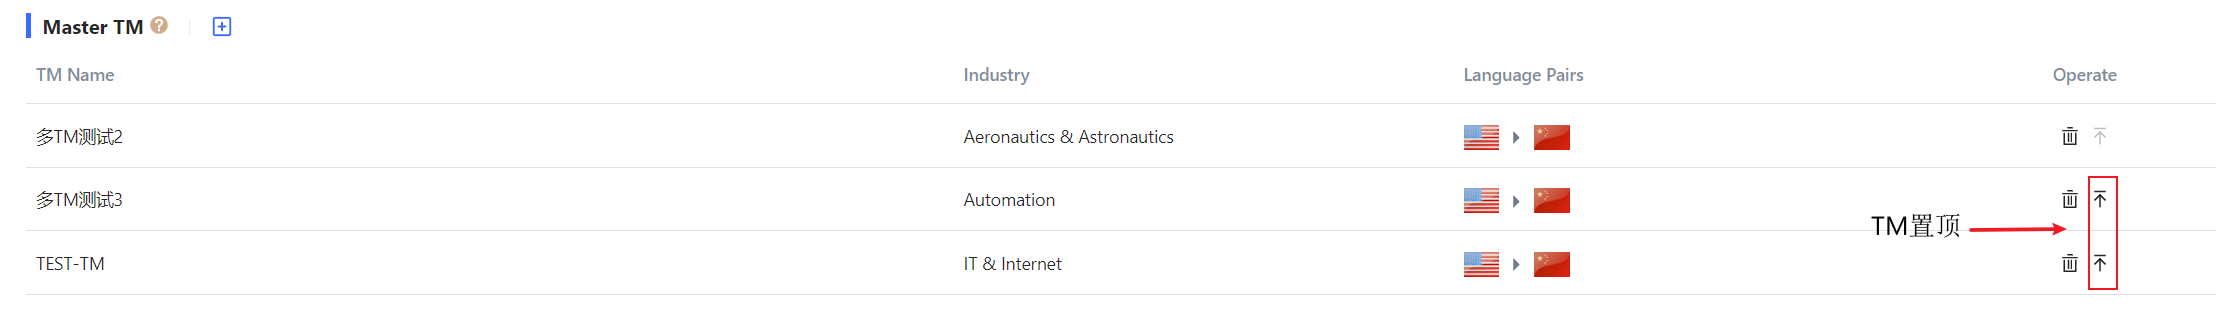
保存选择的TM后,可以在列表中删除或通过下图所示的置顶功能调整多个TM的顺序,Master TM的顺序会影响相同匹配率时候的优先级。
当有多个Master TM时,可以设置减分策略。
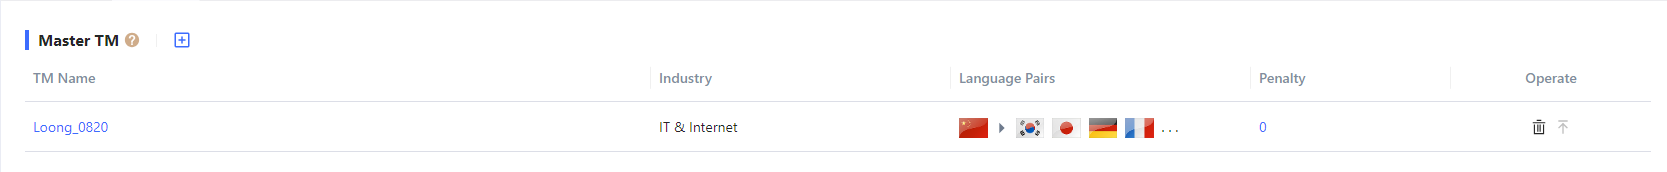
点击Penalty列下的数值后,可针对当前TM进行设置
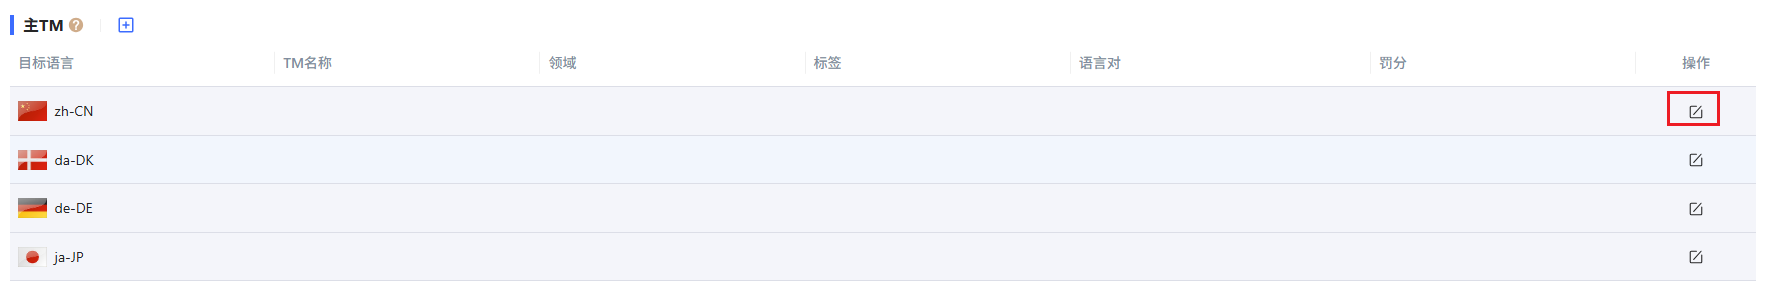
语种TM选择:当有部分语种需要单独使用TM时可在语言对后通过按钮为单个语种进行选择
1.3.2 Reference TM
Reference TM即参考TM,不限制语言对,该用户所有TM都可以被设置为参考TM,在在线编辑时作为只读TM提供查询功能,添加方式与Master TM一致。
1.3.3 Workflow TM
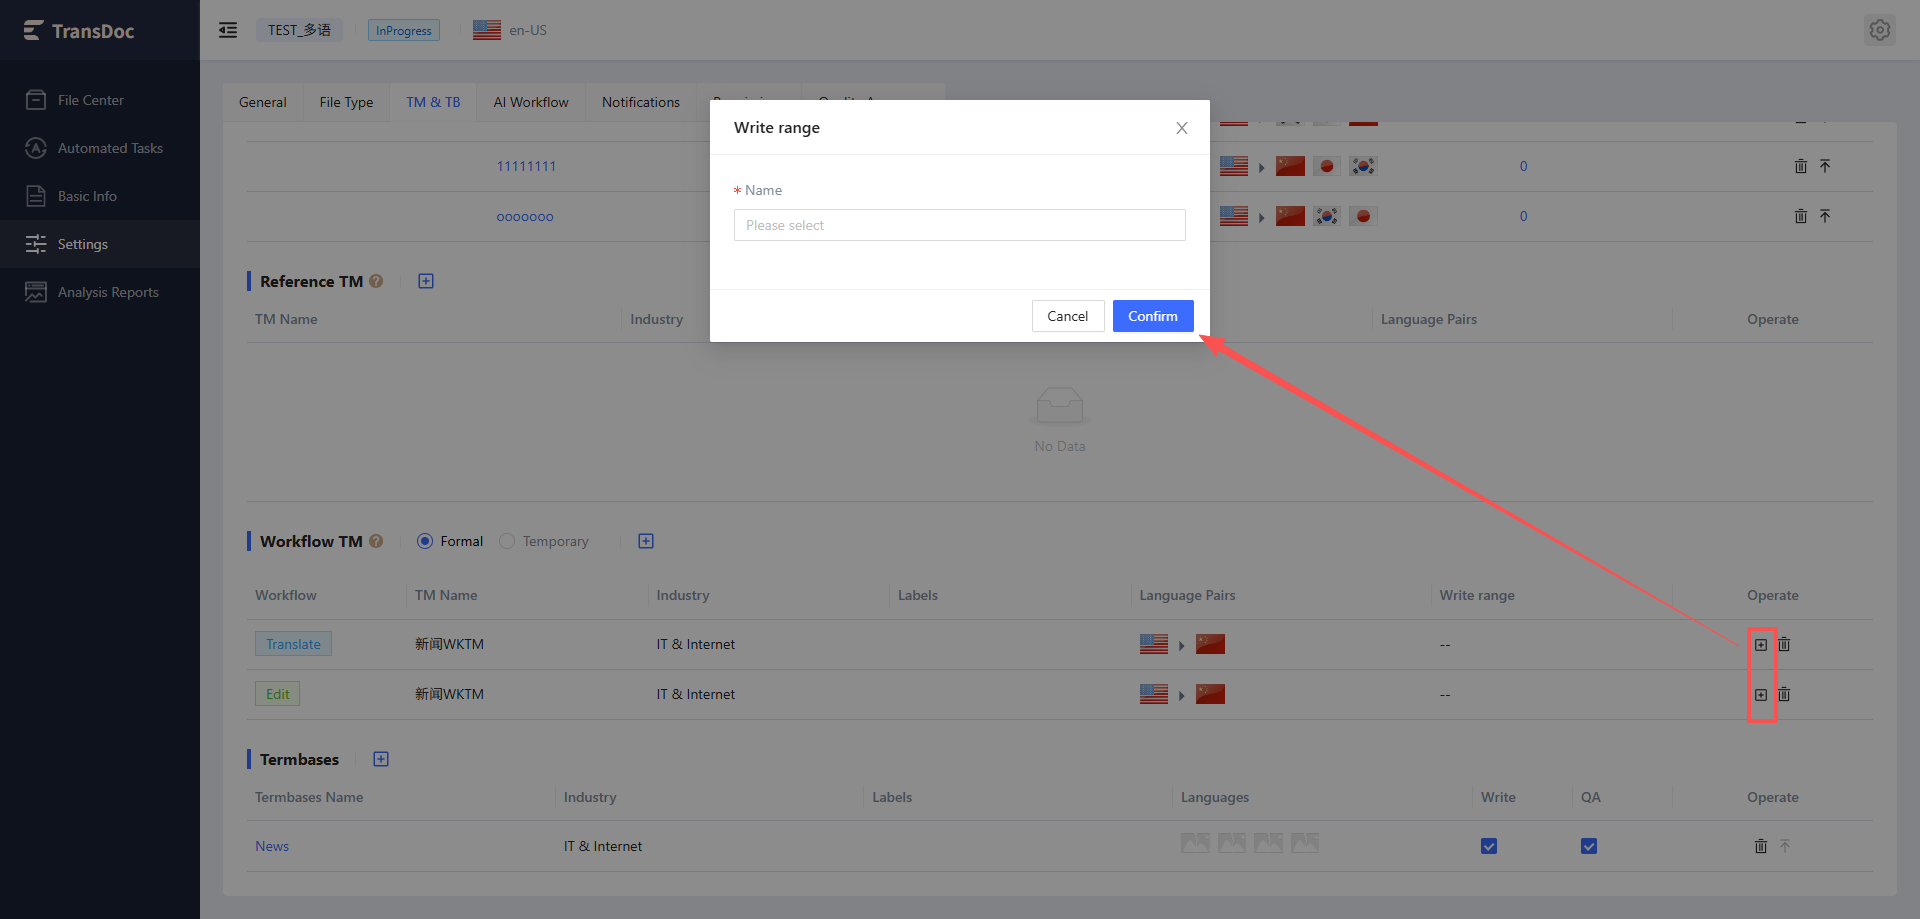
Workflow TM即流程TM,Translate/Edit/Proof 分别设置,步骤间相互独立,选择时有语言对限制,限制规则与Master TM一致,流程TM在译员在线编辑时作为读写TM提供查询与写入功能,添加方式与Master TM一致。译员翻译过程中产生的语料会写入Workflow TM
- Workflow TM有两种添加方式
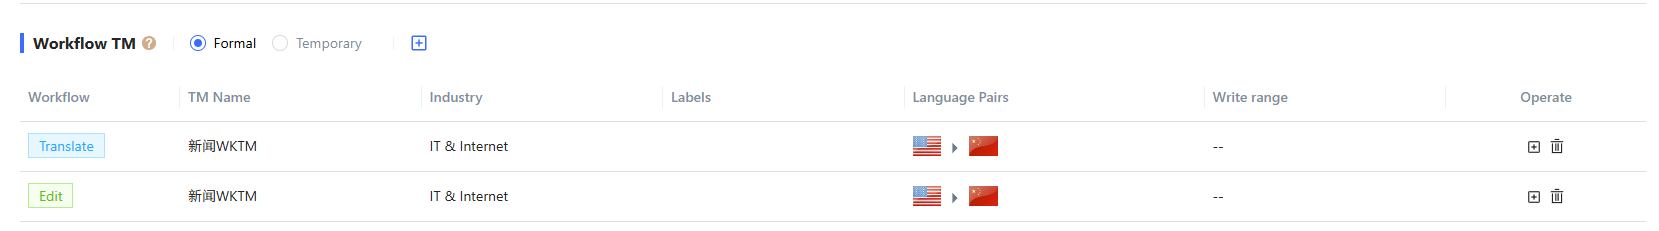
▲ 勾选 Formal
该模式下添加方式与Master TM一致,可通过新建或选择已存在的TM来关联
▲ 勾选 Temporary
此为创建临时TM选项,勾选后所有workflow节点会生成临时TM,临时TM不会显示在其他TM列表页,项目关闭后临时TM也会关闭
- 新人TM
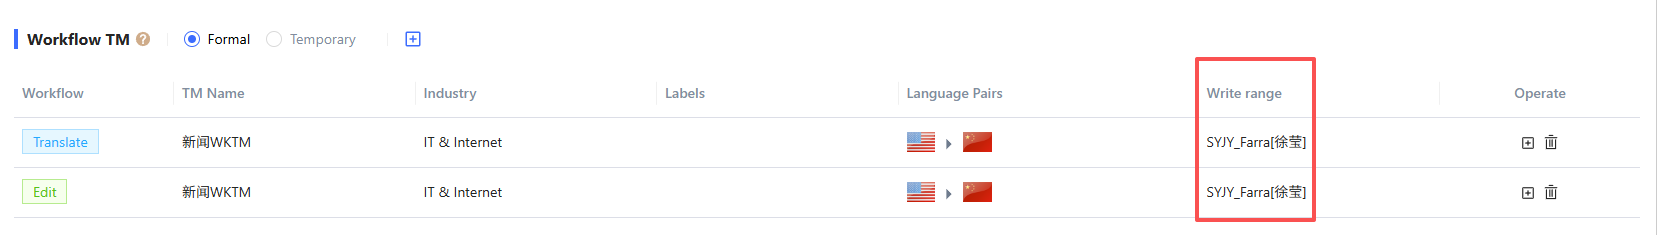
针对新人单独设置一个Workflow TM,在翻译过程中这个新人的内容都写入单独的TM,没有写入其他workflow TM的权限,但不影响这个新人能够读取其他workflow TM
针对译员写入TM的优先级判断:专属TM>通用TM,有专属TM时不向通用TM里写入
1.3.4 Termbases
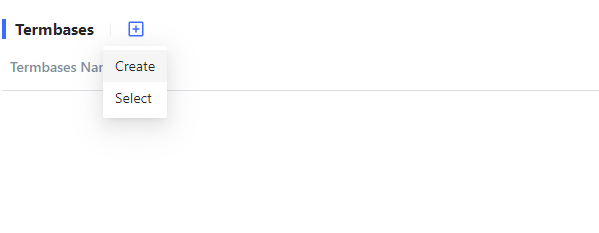
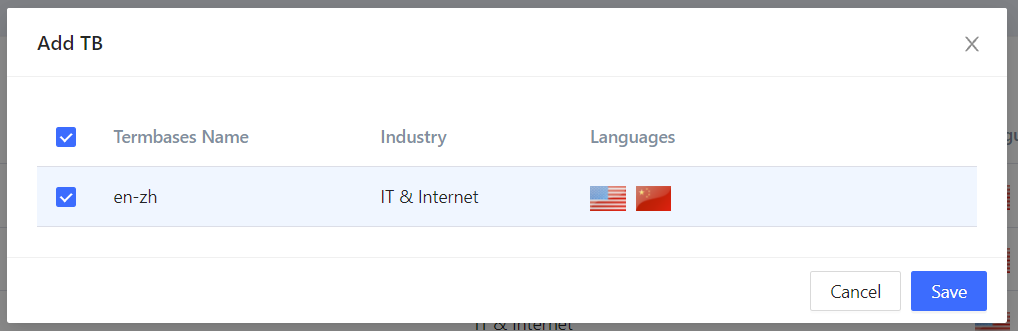
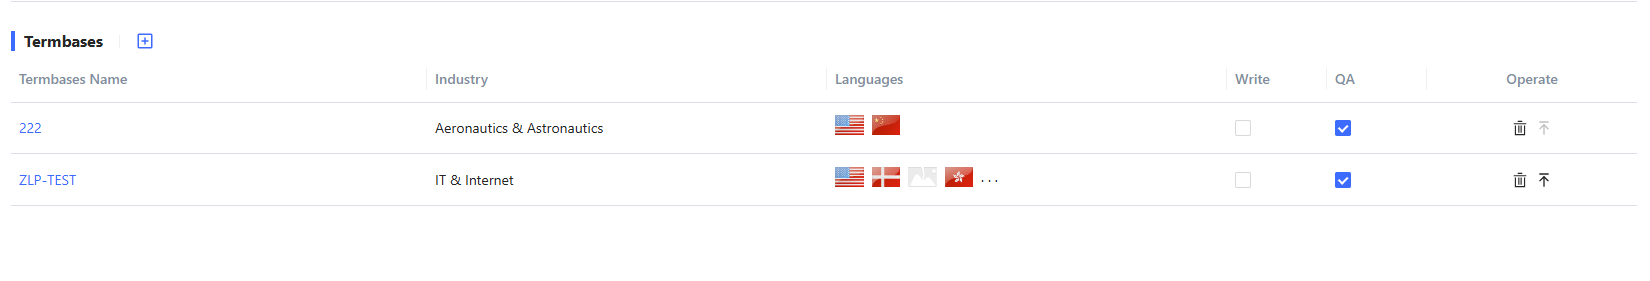
Termbase即术语库,在在线编辑时提供术语库查询功能,选择时有语言对限制,限制规则与Master TM一致,同时也支持创建一个空的术语库进行关联,关联后可设置写入权限以及QA权限
1.4 AI Workflow
Ai Workflow设置是指系统在预翻译阶段进行文件的智能翻译,这里可以根据项目实际情况进行不同的设置,同时支持按照语言对设置
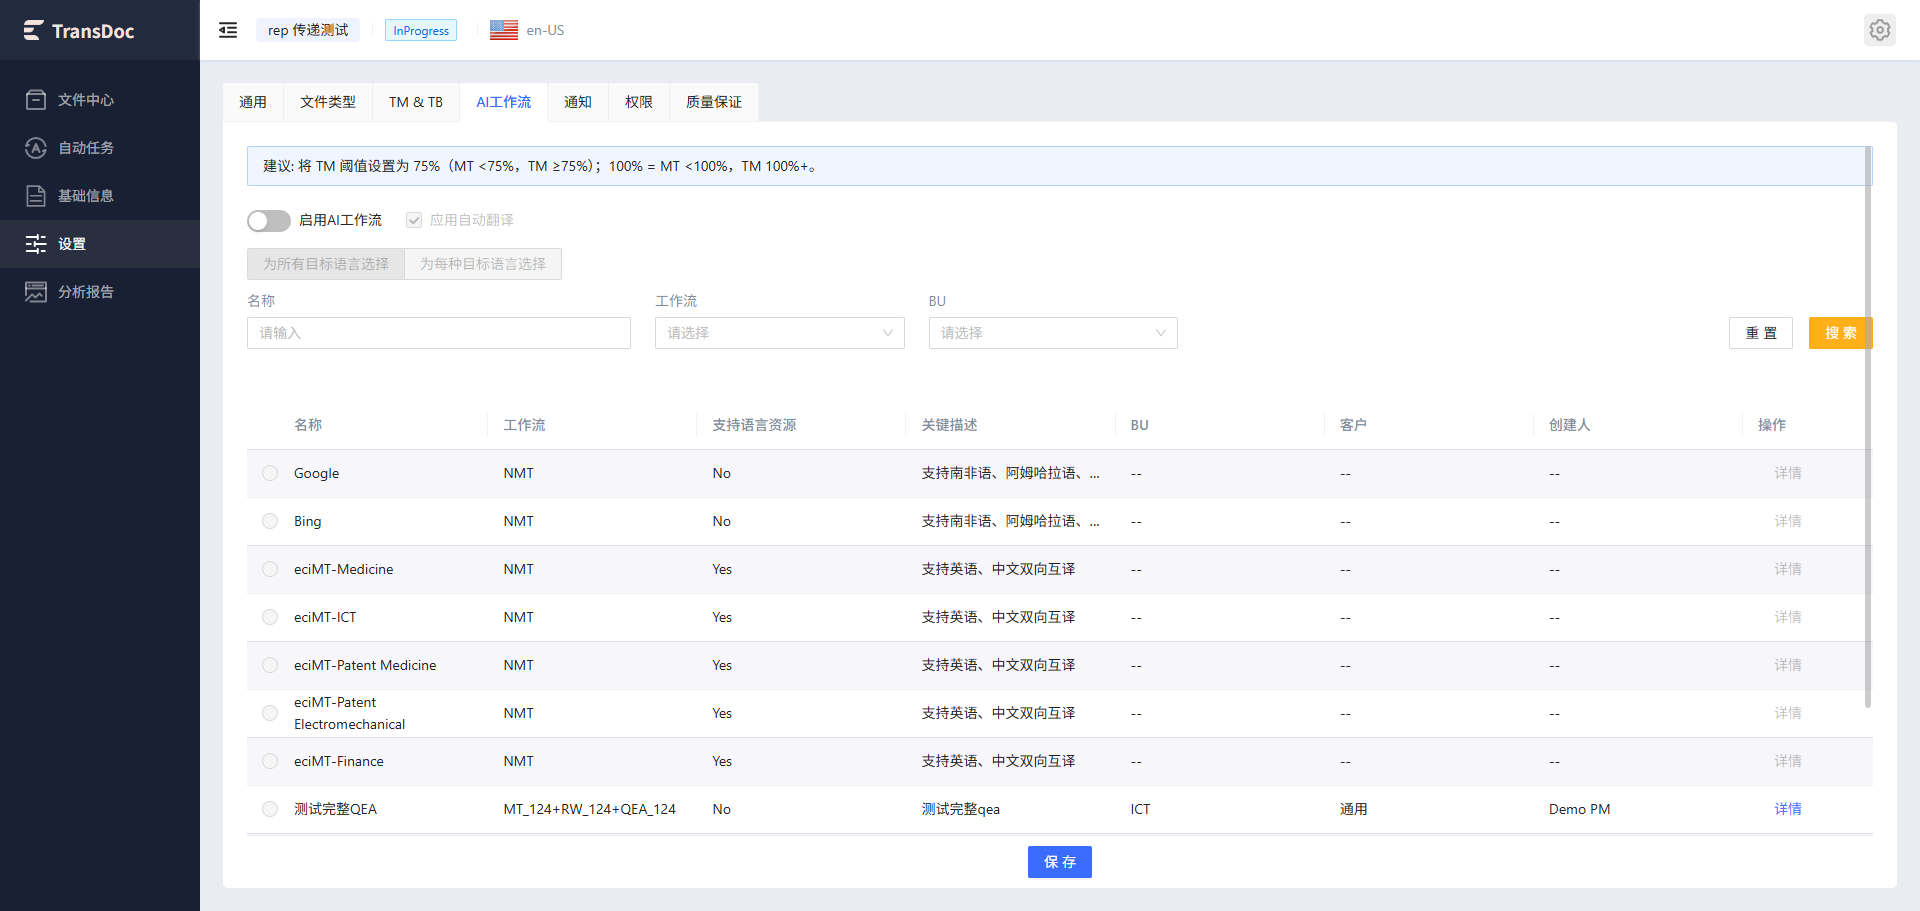
要使用机器翻译,建议将翻译记忆库 (TM) 匹配率阈值设置为 75%。示例:1 、当 TM 匹配率阈值设置为 75% 时:匹配率低于 75% 的文本片段将由机器翻译 (MT) 处理。匹配率达到或超过 75% 的文本片段将使用 TM 匹配。2、当 TM 匹配率阈值设置为 100% 时:匹配率低于 100% 的文本片段将由机器翻译 (MT) 处理。匹配率达到或超过 101% 的文本片段将使用 TM 匹配。
Google:目前支持大部分语种 Deepl:DeepL API大约支持55种可能的词汇表语言对 Bing:目前支持大部分语种 ECI医药:医药领域ECI自研机翻引擎 ECI金融:金融领域ECI自研机翻引擎 ECI智慧制造:智慧制造领域ECI自研机器翻译引擎 ECI专利-机电:专利机电领域ECI自研机器翻译引擎 ECI专利-医药:专利医药领域ECI自研机器翻译引擎
- 应用自动翻译:勾选后会将机翻引擎返回内容直接落入到译文处,未勾选则只展示在CAT面板中
目前机翻工具Google、Deepl、Bing通过API调用,费用由集团承担;机翻工具只能选择一种,使用机翻工具进行落译文操作
1.5 Notifications
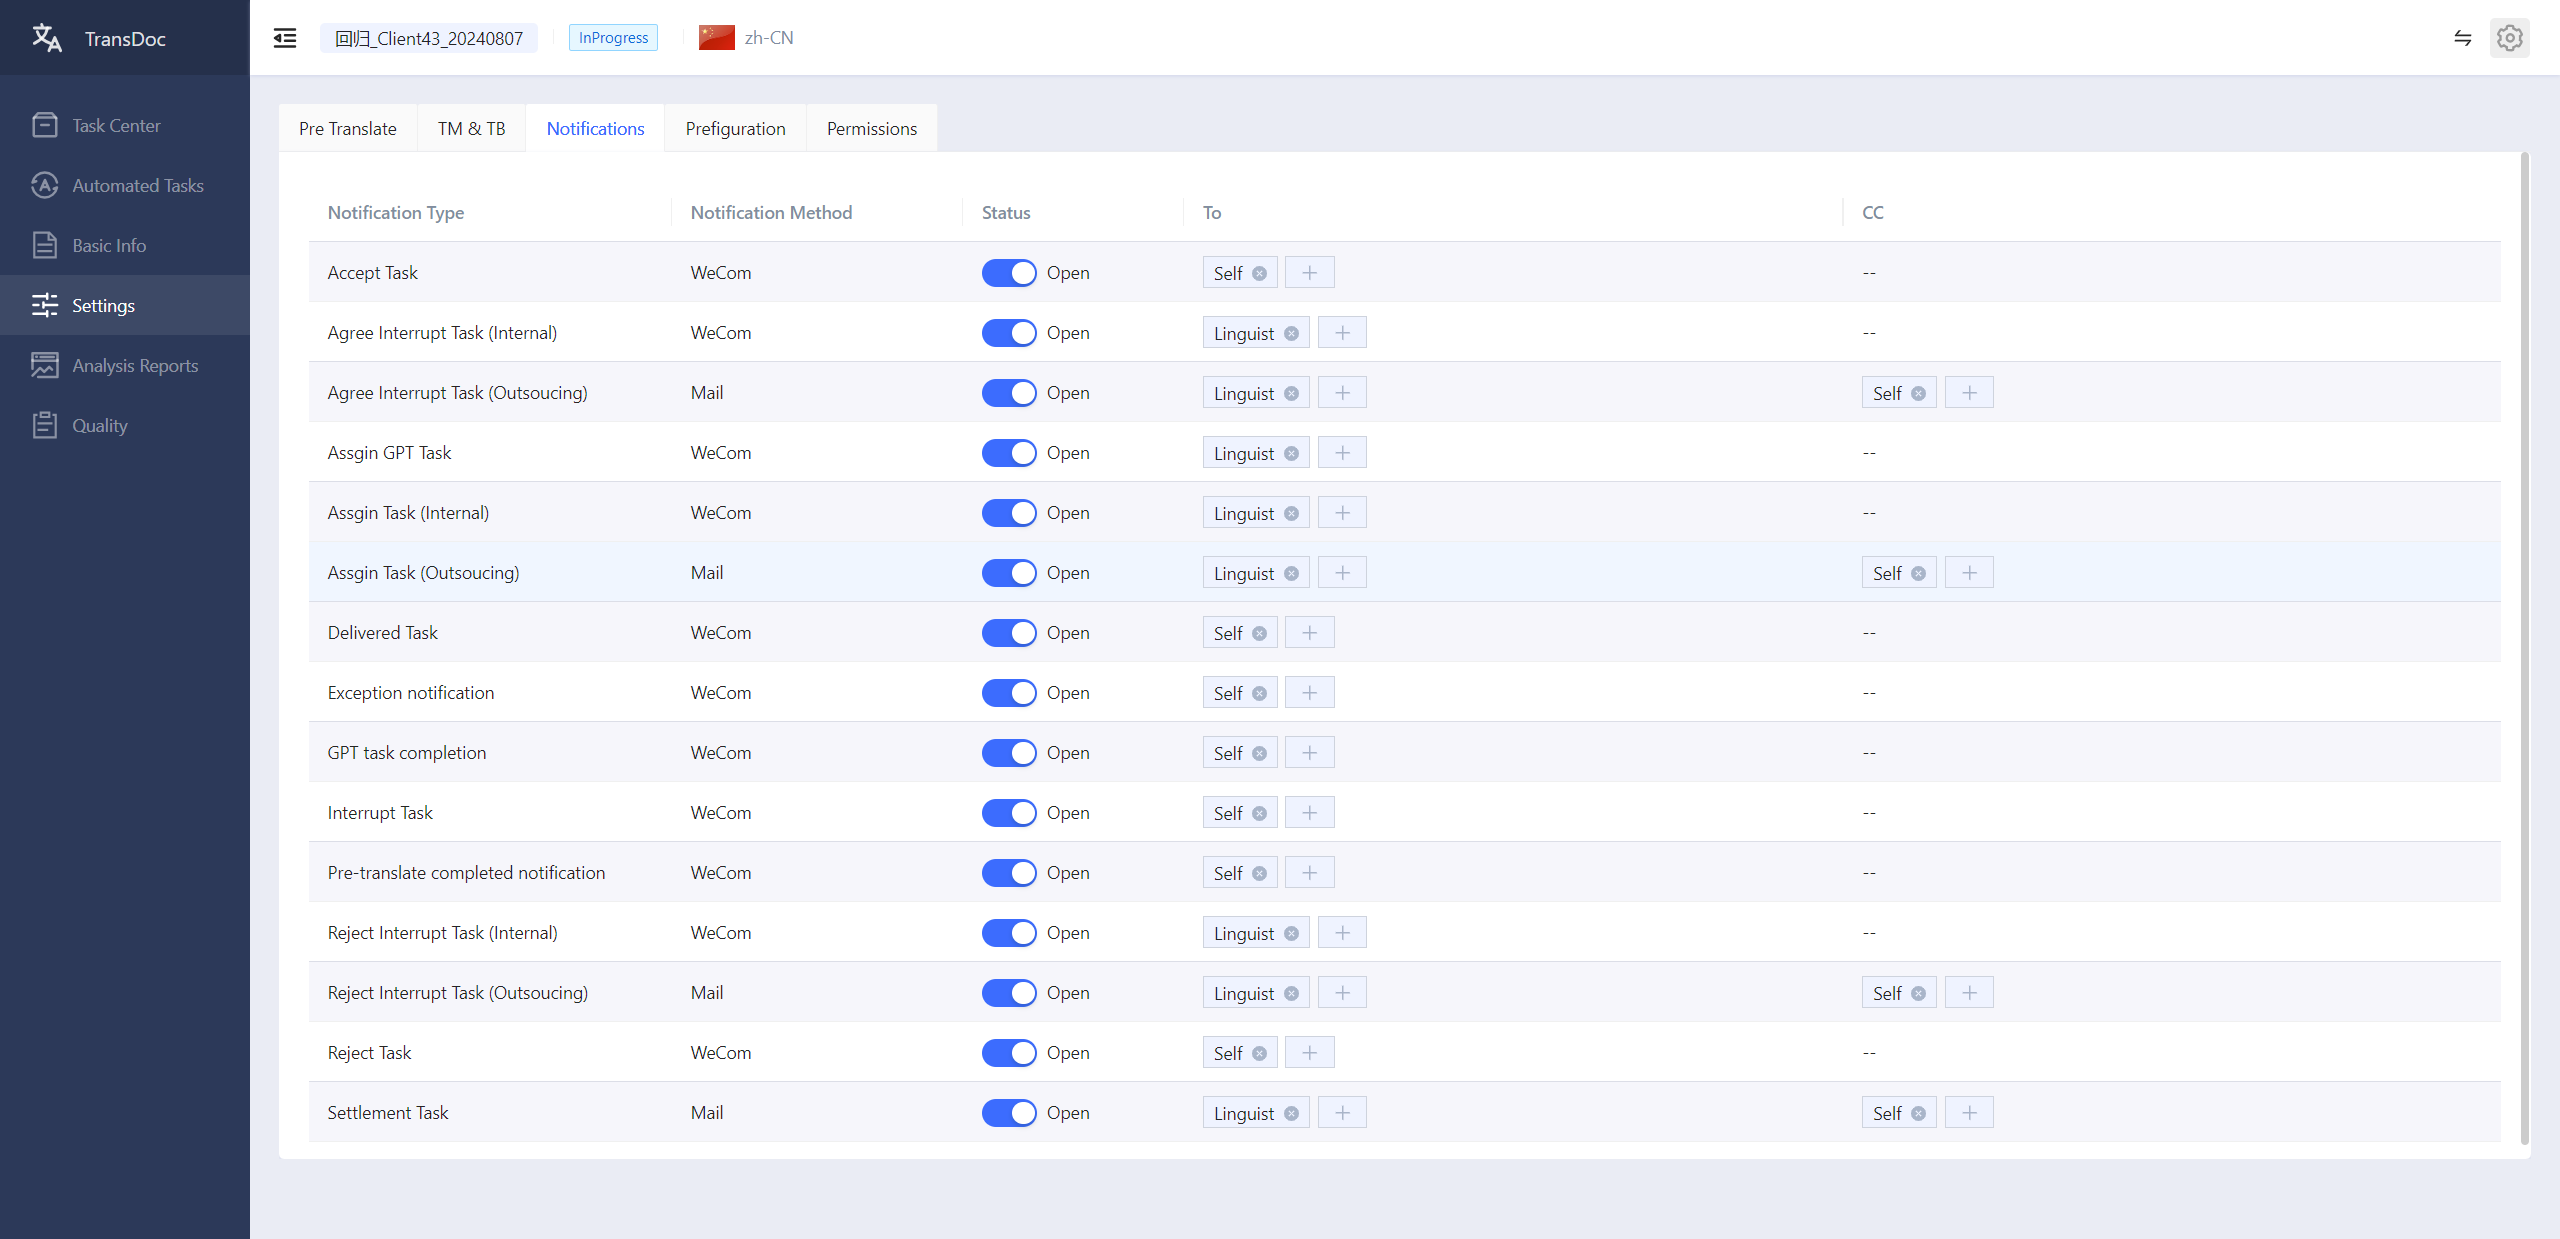
消息通知设置是指在系统会根据一些操作来提示相应人员进行下一步操作等。目前通知分为两种类型,一种是企业微信、另一种是邮件,内部员工默认采用企业微信,外部资源默认采用邮件。消息接收人或者抄送人中可以选中自己、译员以及其他PM。
1.6 Permissions
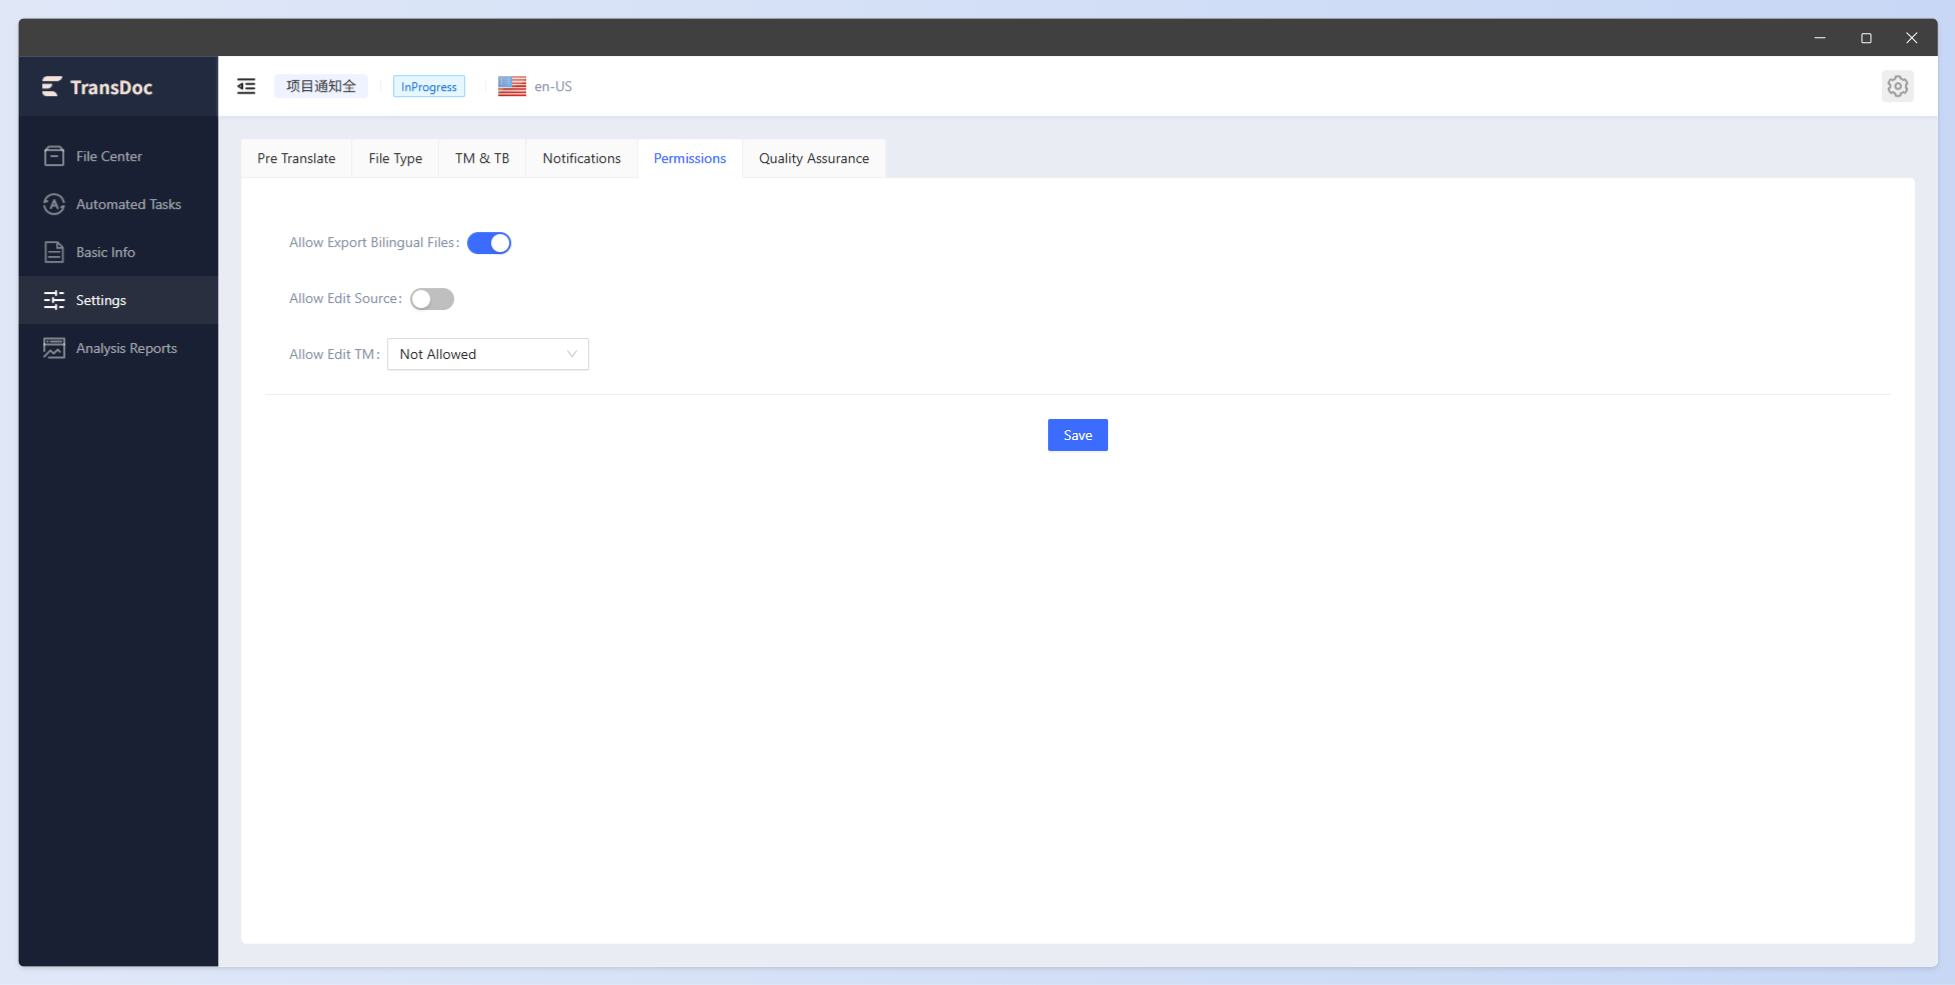
Allow Export Bilingual Files
允许译员下载双语文件
Allow Edit Source
允许译员编辑原文
1.7 Quality Assurance
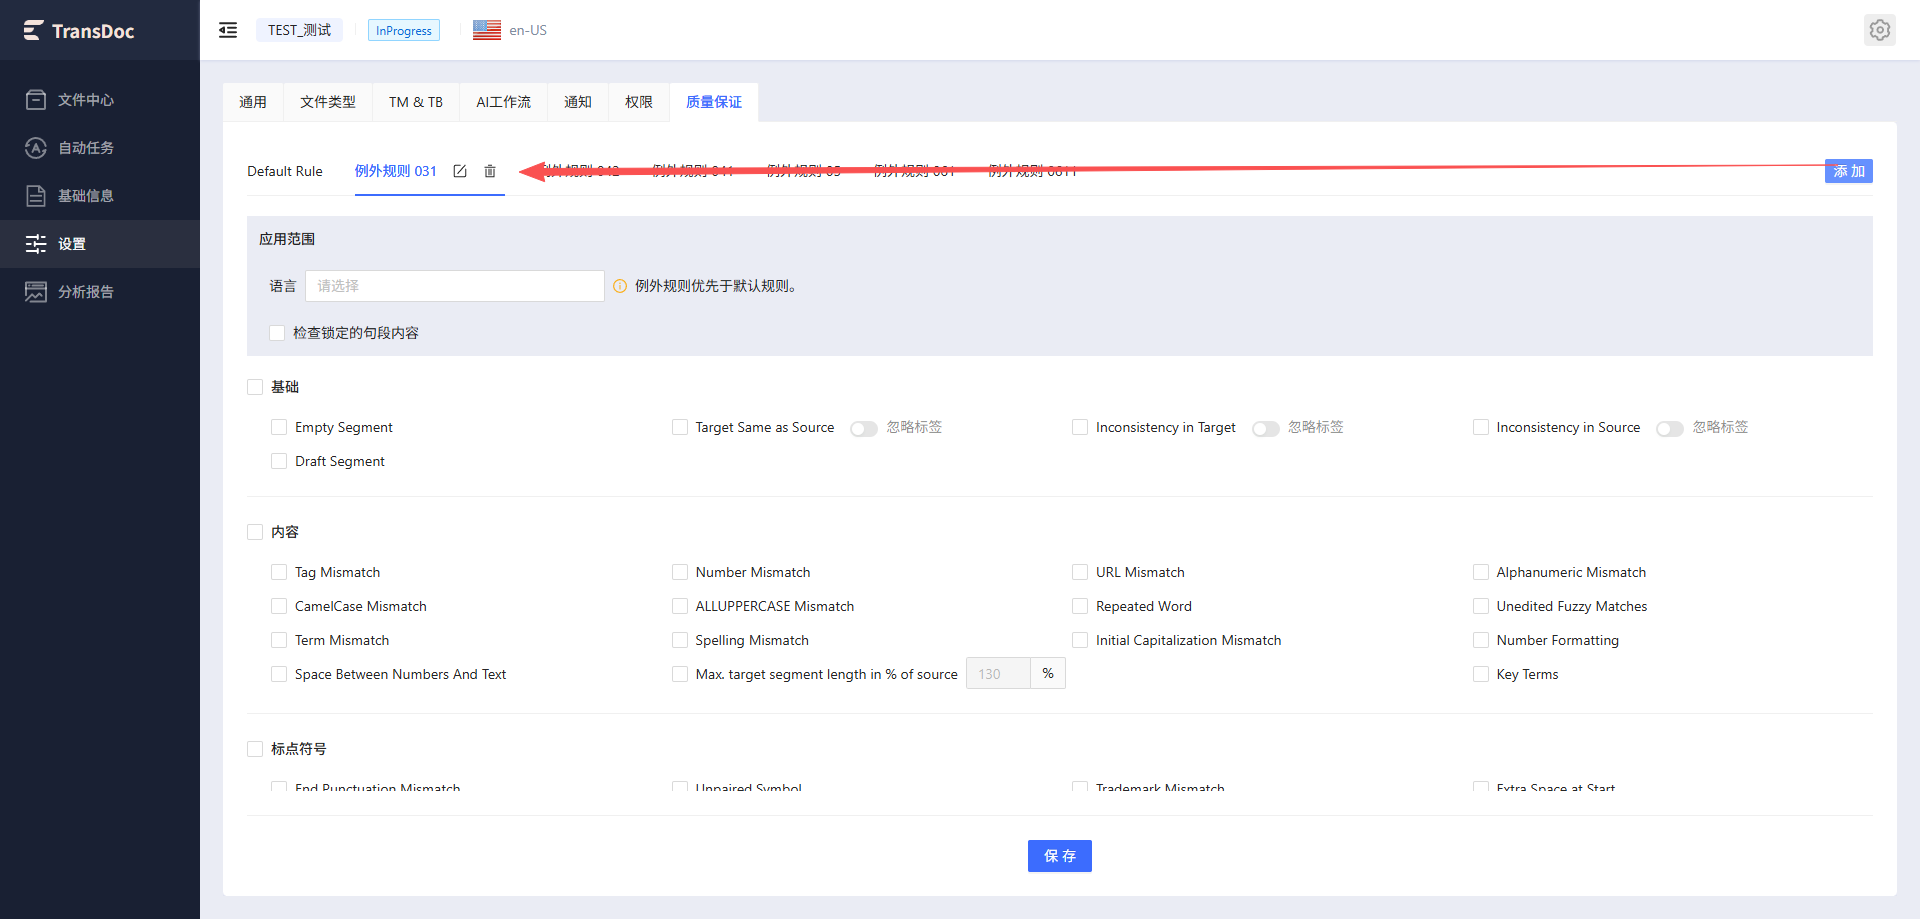
QA检查项设置,可针对项目或客户要求设置不同的检查项
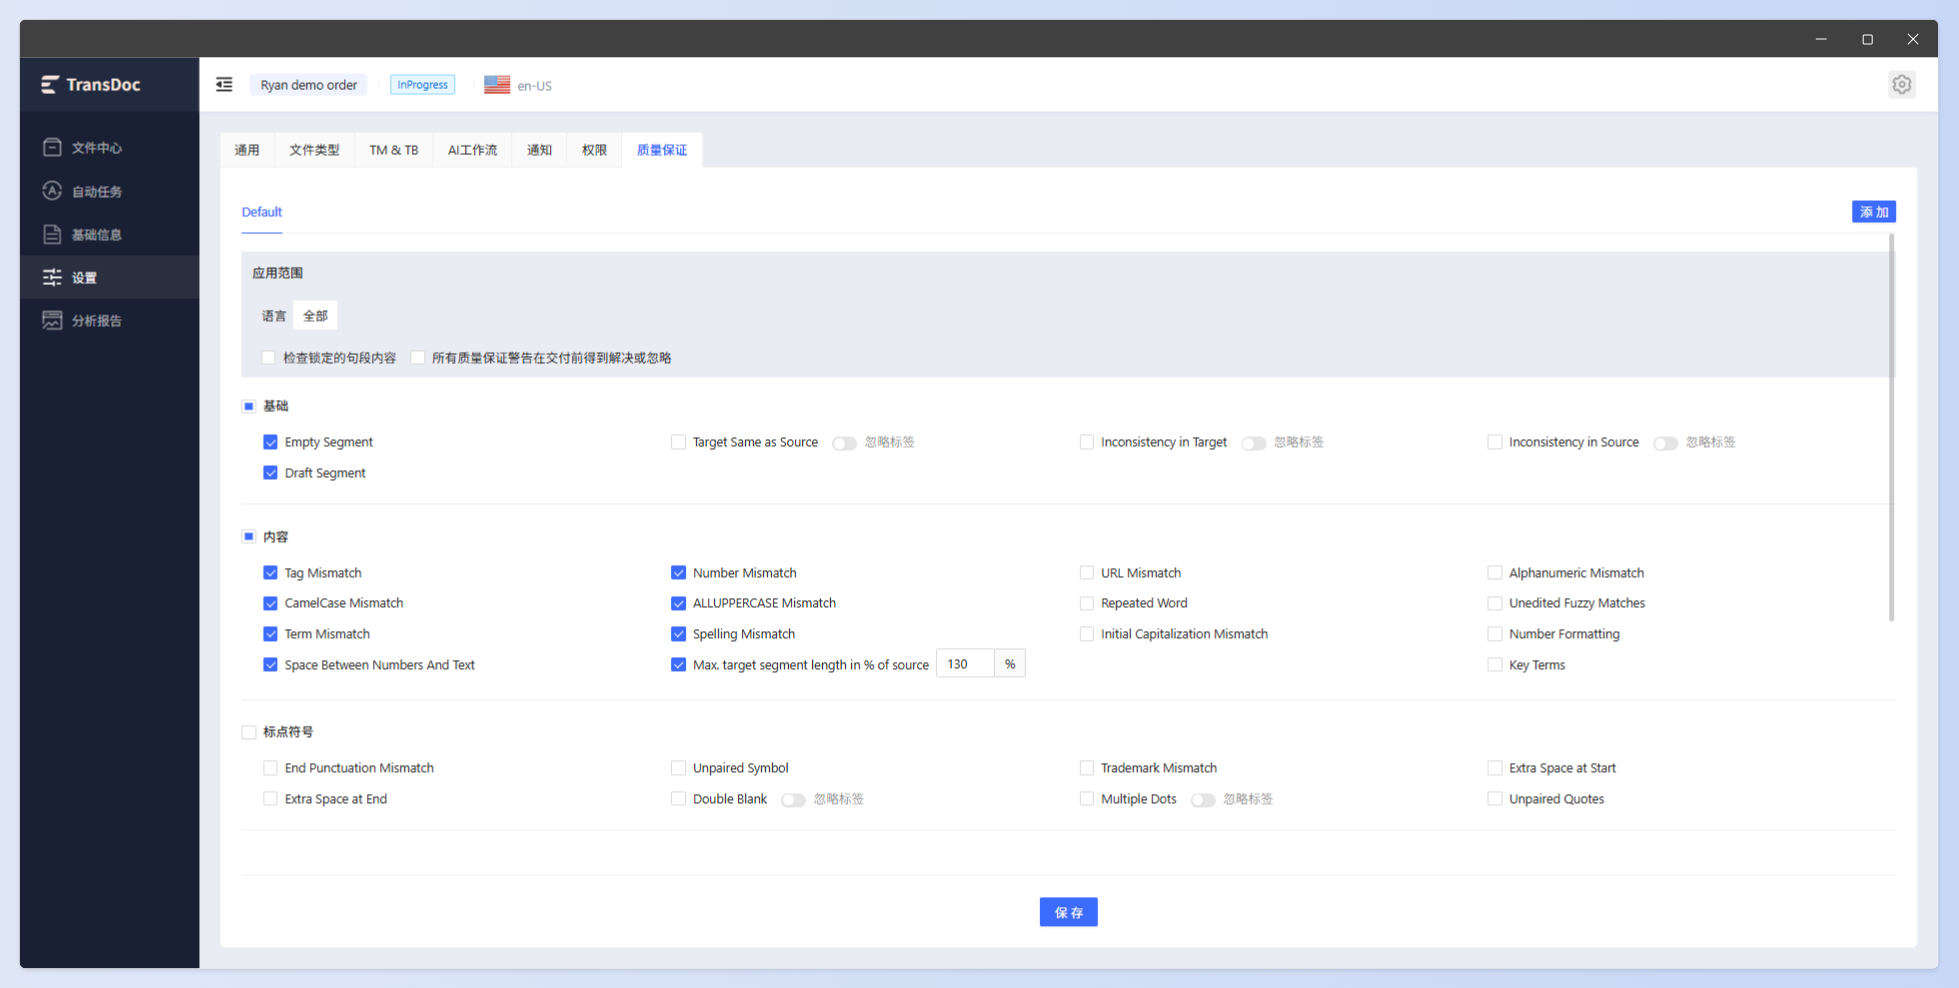
- 检查锁定句段:勾选后QA检查时将检查已锁定句段
- 所有质量保证警告在交付前得到解决或忽略:勾选后,译员在交付文件时需将所有QA 检查出的错误进行处理或忽略,否则无法提交文件
- 检查项对应含义如下:
| 序号 | 质检类型 | 描述 |
|---|---|---|
| 1 | Empty Segment | 检查当前句段是否是空译文 |
| 2 | Target Same as Source | 检查是否存在原文和译文内容一样的情况 |
| 3 | inconsistency in Target | 原文相同但译文不同 |
| 4 | Inconsistency in Source | 原文不同但译文相同 |
| 5 | Tag Mismatch | Tag不一致检查,包括Tag缺少、Tag增多、Tag内容不一致、Tag顺序不一致等情况 |
| 6 | Number Mismatch | 原文和译文内的数字一致性检查,原文有的数字译文内没有,或者原文没有的数字而出现在译文内。即原文和译文双向都检查,包括数字的内容、个数是否一致。 |
| 7 | URL Mismatch | 检查原文和译文URL不一致情况 |
| 8 | Alphanumeric Mismatch | 原文和译文内的字母+数字组合的单词是否一致,即原文和译文双向都检查,包括组合单词的个数和内容是否一致。 |
| 9 | CamelCase Mismatch | 原文和译文内的驼峰字(单词内含有两个及以上的大写字母,同时含有小写字母)是否一致。若原文的驼峰字单词未出现在译文内,或原文没有的驼峰字单词而出现在译文内。原文和译文双向都检查,包括驼峰字个数和内容是否一致。 |
| 10 | All UPPERCASE Mismatch | 原文和译文内的“全大写”单词一致性检查。若原文的全大写单词未出现在译文内,或原文没有的全大写单词而出现在译文内。即原文和译文双向都检查,包括全大写单词的个数和内容是否一致。 |
| 11 | Repeated Word | 文本中出现重复的字、词。例子:which the data uploaded uploaded |
| 12 | Unedited Fuzzy Matches | 检查未经编辑的模糊匹配 |
| 13 | Term Mismatch | 术语一致性检查,若原文某个单词出现在术语表,而译文不存在对应语种的术语,则报错。 |
| 14 | Spelling Mismatch | 译文内存在拼写错误 |
| 15 | Initial Capitalization Mismatch | 检查原文首字母和译文首字母大写不一致情况 |
| 16 | Number Formatting | 检查原文和译文的数字格式是否一致 |
| 17 | Space Between Numbers And Text | 原文和译文内数字和空格一致性检查。若原文的数字和空格未出现在译文内,或原文没有的数字和空格而出现在译文内。即原文和译文双向都检查 |
| 18 | End Punctuation Mismatch | 检查原文和译文结束标点是否一致 |
| 19 | Unpaired Symbol | 例如原文中出现了(),但是译文中未出现,注意不同符号在不同语种可能存在不一致 |
| 20 | Trademark Mismatch | 原文和译文内的商标一致性检查。若原文的商标未出现在译文内,或原文没有的商标而出现在译文内。即原文和译文双向都检查,包括商标的个数和内容是否一致。 |
| 21 | Extra Space at Start | 译文开始前有多余空格,则报错 |
| 22 | Extra Space at End | 译文结束后有多余的空格 |
| 23 | Double Blank | 当两个字符之间出现了超过一个的连续空格 |
| 24 | Multiple dots | 存在连续两个及以上重复的标点符号 |
| 25 | Unpaired quotes | 检查译文中是否存不成对的引号 ,在例如原文中出现了'',但是译文中未出现 |
| 26 | Max. target segment length in % of source | 检查译文长度大于或小于原文百分比 |
| 27 | Multiple Punctuations | 检查译文中是否连续出现多个标点符号 |
| 28 | Key Terms | 检查关键术语,将一句话作为术语与其他句段中的某一段译文对比是否一致。 |
| 29 | AI Check | 新增AI 检查项,该检查项需要在AI Workflow平台配置, AI质检在提交任务时触发,每个文件只检查一次 检查结果需要译员人工标注“已解决”后才能提交 会消耗一定的Token,请根据项目需求合理使用 |
此外,支持针对不同语种设置不同的检查项;
- 通过点击添加按钮,增加例外规则标签,名称可以编辑;
- 然后在页面中选择要设置的语种(可多选),单独设置规则即可;